企业买了 GPU,模型也部署好了,知识库却迟迟没有形成稳定服务:文档更新后无法及时入库,多人检索时响应忽快忽慢,训练任务还在与备份作业争抢数据通道。遇到这些问题,企业需要沿着整条数据链路寻找原因。
在信乘数据看来,企业智能化建设需要同时回答三个问题:模型是否适合任务,业务流程是否接得住,以及数据能否持续、可靠地送到应用面前。XC-Flash 全闪存存储,正是我们围绕第三个问题组织企业 AI 数据基础设施方案的核心。
以全闪数据底座连接业务资料、数据处理与 AI 算力,围绕真实工作负载配置性能、保护与访问控制,把存储建设落实到应用效果。
01 / 业务判断企业 AI 的效率,取决于整条数据链路
传统企业存储的典型任务,是支撑数据库、业务系统和文件共享。AI 又加入了新的访问方式:批量读取文档做解析,反复扫描样本做训练,同时保存模型权重、检查点和生成结果。不同任务叠加后,容量充足并不代表数据供给充足。
例如,制造企业搭建设备维修助手,背后需要处理手册、工单、图纸和现场照片。新工单要进入知识处理流程,历史资料要建立索引,回答问题时还要回溯原文。任何一环拥堵,都可能拖慢服务。全闪介质有助于改善随机访问和并发读写,但最终效果仍取决于网络、元数据处理、数据库与应用设计。
因此,我们建议把 XC-Flash 放进业务链路评估:关注资料从产生到可检索要多久、并发访问时延是否稳定、训练是否因等待读取而停顿,而不只比较存储设备的峰值带宽。
02 / 方案架构围绕一份可信数据,组织多类智能应用
XC-Flash 企业智能化方案以共享全闪数据底座为中心,在业务系统与 AI 应用之间组织数据接入、处理、访问和保护。以下是参考逻辑结构,实际部署按接口、权限与工作负载拆分资源。
企业文档、研发资料、工单、影像、生产日志,以及经授权导出的业务数据。
承载纳入 AI 流程的原始资料、处理结果、模型文件和检查点;按项目规划访问协议、资源隔离与数据保护。
由解析、清洗、向量化、向量数据库、模型运行框架及任务调度软件完成处理;存储提供底层数据承载。
面向知识助手、研发助手、视觉质检与科研计算,为业务人员提供可追溯、可管理的智能服务。
这一设计的重点,是减少项目之间重复搬运大文件和维护多份原始资料的负担。共享数据底座并不意味着开放所有数据:部门、项目和应用账号仍需按职责授权,检索阶段也要继承原始资料的权限边界。
03 / 场景落地从企业知识库,走向智能体与行业应用
企业知识库与办公助手:让资料更新进入业务节奏。将制度、合同模板、产品手册等资料纳入受控数据区,经增量解析与向量化后更新索引。XC-Flash 方案承载原文和处理产物,配合上层软件把“新资料可用时间、引用可追溯性、并发检索体验”纳入验收。向量检索与答案生成由对应数据库和模型服务负责。
企业智能体:把每一次行动放在可管理的数据基础上。采购、售后或运维智能体需要读取资料、调用系统并保存任务产物。方案中可将知识文件、任务附件与执行记录分区管理,配合应用权限、审计与人工审批。存储提供可靠的数据承载,业务系统负责交易一致性,智能体平台负责工具授权与执行控制。
研发与科研:减少样本准备和训练恢复的等待。高校、科研机构及企业研发团队经常同时处理仿真结果、图像、实验记录和模型文件。方案重点评估多任务读取、海量文件访问、检查点写入与恢复,在代表性样本上验证性能,再确定资源规模。版本化数据集和实验记录由数据管理工具协同维护。
医疗影像与工业视觉:把持续新增的数据变成可用样本。影像和产线图片既有日常调阅需求,也可能用于标注、训练和推理。我们建议将业务在线访问与 AI 批处理进行资源隔离,先验证真实影像或图片的访问模式,再规划热点数据范围。医疗场景还需落实脱敏、访问审批和适用的数据合规要求。以上均为方案示例,不代表已交付案例。
04 / 算力协同让 GPU 少等待,先找准真正的瓶颈
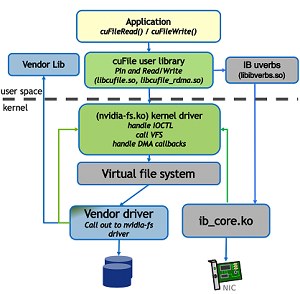
在数据密集型训练与分析中,数据从存储进入 GPU 的路径值得单独优化。NVIDIA GPUDirect Storage(GDS)在适用配置下,可建立存储到 GPU 显存的直接数据通道,减少经 CPU 内存中转的数据复制。[1]
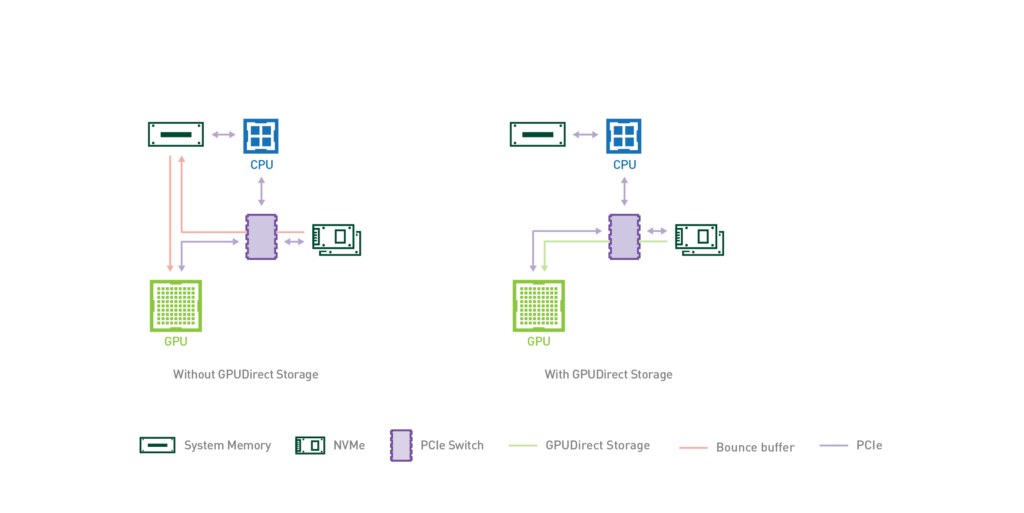
在 XC-Flash 方案设计中,我们将这类数据通路优化作为选配评估项:需要联合核验存储协议、文件系统、GPU、网卡、驱动、PCIe 拓扑和应用接入方式。配置了全闪存储,并不自动获得 GDS 能力。是否适用、收益多少,应由具体软硬件组合的测试决定。
如果模型已经驻留显存,在线推理的主要瓶颈可能是计算、显存容量或调度;小规模知识库也可能主要受检索、重排和模型生成耗时影响。这些场景应先定位瓶颈。XC-Flash 的建设价值,需要由实际数据访问需求来支撑。
05 / 交付路径从一个可验收的场景开始
诊断:把问题定位到数据链路。梳理数据规模、文件数量、增长速度、访问模式、并发任务与现有网络,建立业务响应和存储访问的基线。
试点:使用真实数据复现高峰。选择知识库、科研训练或视觉样本库中的一个场景,明确数据集、并发数和软硬件配置;同时测试正常运行、备份并行及故障恢复。
扩展:按验证结果确定采购与迁移。结合有效可用容量、应用吞吐和保护要求确定配置,先小范围迁移,再逐步接入更多部门和任务。按相同保护级别比较设备、软件、网络、电力与运维成本。
① 新资料从接入到可检索的时间。
② 目标并发下的端到端响应与 P95 时延。
③ 训练数据等待时间及检查点保存、恢复耗时。
④ 故障、备份和数据恢复期间的业务可用性。
全闪存储也需要清晰的成本边界。低频归档数据可按保留策略放置在更合适的存储层;数据压缩或去重收益应以真实样本测试,不能直接套用宣传比例。把有限预算配置给高频访问、反复计算和直接影响业务体验的数据,才能体现全闪投入的价值。
06 / 信乘数据从数据底座,到业务行动
信乘数据围绕企业存储、基础设施与 AI 应用的协同建设,提供从场景诊断、方案设计到工程实施和效果验证的服务。针对企业智能化项目,我们希望与客户一起,把 XC-Flash 的数据承载能力与模型平台、知识处理流程和业务系统连接起来。
如果您正在建设企业知识库、规划科研算力平台,或希望改善训练数据供给与影像处理效率,可以先与我们交流一个具体场景:目前的数据量、业务并发、最影响体验的等待环节,以及希望达到的结果。
欢迎留言“XC-Flash”,交流业务场景与部署需求;也可通过官网联系,开展方案评估与概念验证。
技术参考:[1] NVIDIA GPUDirect Storage Overview Guide;存储到 GPU 的直接数据路径。技术原理配图保留原始标识与来源。